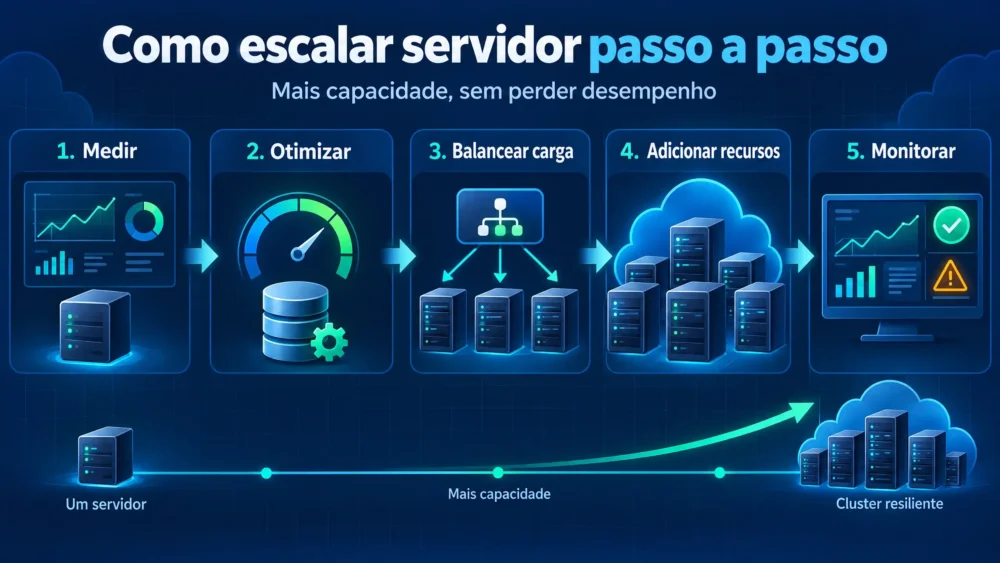
Quando um site, aplicação ou sistema começa a receber mais acessos, chega um momento em que os recursos disponíveis deixam de ser suficientes. CPU, memória RAM, armazenamento, banco de dados ou conexões podem se tornar gargalos. É nesse cenário que entender como escalar servidor passa a ser fundamental.
A escalabilidade permite aumentar a capacidade de uma infraestrutura sem necessariamente reconstruir toda a aplicação. Dependendo do problema, isso pode significar adicionar RAM, aumentar o número de vCPUs, migrar para armazenamento NVMe, otimizar PHP-FPM, utilizar Redis, separar o banco de dados ou distribuir o tráfego entre vários servidores.
Neste guia, você aprenderá como escalar servidor Linux de forma organizada, começando pelo diagnóstico e avançando até arquiteturas com múltiplos servidores, Load Balancer, cache e banco de dados dedicado.
O objetivo não é simplesmente adicionar recursos. O objetivo é descobrir qual componente está limitando a infraestrutura e aumentar a capacidade exatamente onde existe o gargalo.
O que significa escalar um servidor?
Escalar um servidor significa aumentar sua capacidade para suportar maior quantidade de usuários, requisições, processos, dados ou operações simultâneas.
Existem duas estratégias principais:
Escalabilidade vertical
Também chamada de scale-up, consiste em aumentar os recursos do servidor existente.
Por exemplo:
4 vCPU
8 GB RAM
100 GB SSD
pode ser atualizado para:
8 vCPU
16 GB RAM
200 GB NVMe
Depois:
16 vCPU
32 GB RAM
400 GB NVMe
Essa abordagem costuma ser mais simples porque a aplicação continua funcionando em uma única máquina.
Escalabilidade horizontal
Também chamada de scale-out, consiste em adicionar servidores.
Em vez de possuir apenas:
Servidor 01a arquitetura pode evoluir para:
Servidor 01
Servidor 02
Servidor 03
Um Load Balancer distribui as requisições entre os servidores.
Essa estratégia permite crescer além dos limites físicos de uma única máquina.
Quando é necessário escalar um servidor?
Nem todo servidor precisa ser escalado.
Antes de aumentar os recursos, identifique se realmente existe um gargalo.
Alguns sinais comuns são:
- CPU constantemente elevada;
- memória RAM próxima do limite;
- uso excessivo de swap;
- alto I/O wait;
- disco com latência elevada;
- armazenamento próximo da capacidade máxima;
- PHP-FPM atingindo o limite de processos;
- MariaDB com muitas conexões;
- aumento do tempo de resposta;
- erros HTTP 502, 503 ou 504;
- processos sendo finalizados por falta de memória;
- crescimento constante do Load Average;
- aumento de filas de processamento.
Por isso, aprender como escalar servidor começa muito antes de contratar uma máquina maior.
O primeiro passo é medir.
1. Monitore o servidor antes de fazer alterações
Antes de aumentar CPU, RAM ou armazenamento, obtenha informações sobre o comportamento atual.
Comece com:
uptimeDepois:
free -hVerifique armazenamento:
df -hE inodes:
df -iPara observar processos:
topOu, caso esteja instalado:
htopTambém é importante analisar memória, CPU e processos simultaneamente:
vmstat 1 10Para armazenamento:
iostat -xz 1 10Caso iostat não esteja disponível:
dnf install sysstatou em sistemas Debian/Ubuntu:
apt install sysstatEsses dados ajudam a determinar se o problema realmente está na capacidade computacional ou em outro componente.
2. Identifique o gargalo
A etapa mais importante de como escalar servidor é identificar o recurso que está impedindo o sistema de crescer.
Imagine um servidor com:
16 vCPU
32 GB RAM
NVMe
Se a CPU está em 30%, a RAM em 50% e o disco apresenta latência elevada, adicionar mais CPU provavelmente não resolverá o problema.
Nesse caso, o armazenamento pode ser o gargalo.
Da mesma forma, se o servidor apresenta:
CPU: 40%
RAM: 95%
Swap: crescente
o problema provavelmente está relacionado à memória.
Uma análise básica pode ser feita com:
uptime
free -h
vmstat 1 10
iostat -xz 1 10
3. Analise o Load Average
O Load Average é uma das métricas mais importantes em servidores Linux.
Consulte:
uptimeVocê poderá encontrar algo parecido com:
load average: 8.20, 7.90, 6.70Os três valores representam períodos diferentes de carga.
Entretanto, o número isolado não deve ser interpretado sem considerar a quantidade de CPUs.
Por exemplo:
Servidor A
2 CPUs
Load: 4.0
é muito diferente de:
Servidor B
16 CPUs
Load: 4.0
Por isso, sempre analise Load Average junto com utilização de CPU, I/O wait e processos.
4. Descubra quem está consumindo CPU
Execute:
ps aux --sort=-%cpu | head -20Isso mostra os processos que estão consumindo mais CPU.
Em servidores web, alguns candidatos comuns são:
- PHP-FPM;
- MariaDB;
- Nginx;
- Apache;
- Redis;
- processos Node.js;
- workers;
- tarefas cron;
- scripts de backup;
- antivírus;
- processos de indexação.
Se PHP-FPM estiver consumindo grande quantidade de CPU, aumentar o número de servidores pode não ser a primeira solução.
Primeiro investigue a aplicação.
5. Analise o consumo de memória
Para verificar a RAM:
free -hExemplo:
               total        used        free
Mem:             32G         29G         1G
Swap:             4G          2G         2G
Esse cenário merece investigação.
Também é importante descobrir quais processos consomem mais memória:
ps aux --sort=-%mem | head -20Em servidores web, PHP-FPM e banco de dados frequentemente estão entre os maiores consumidores.
6. Cuidado com PHP-FPM
PHP-FPM pode consumir uma quantidade significativa de memória quando existem muitos workers simultâneos.
Verifique:
ps aux | grep php-fpmE:
pgrep -c php-fpmA configuração precisa considerar:
RAM total
-
Sistema operacional
-
MariaDB
-
Redis
-
Nginx/Apache
-
outros serviços
=
RAM disponível para PHP-FPM
Não é recomendado simplesmente colocar:
pm.max_children = 1000sem conhecer o consumo real dos processos.
Uma configuração excessivamente agressiva pode causar:
RAM insuficiente
↓
Swap
↓
I/O elevado
↓
lentidão
↓
OOM Killer
7. Escale verticalmente
Depois de identificar um gargalo real, a primeira estratégia pode ser aumentar os recursos da máquina.
Imagine:
VPS atual

4 vCPU
8 GB RAM
160 GB SSD
Uma possível evolução seria:
8 vCPU
16 GB RAM
300 GB NVMe
Essa estratégia é simples porque não exige modificar imediatamente a arquitetura da aplicação.
A escalabilidade vertical é especialmente interessante para:
- sites WordPress;
- aplicações pequenas;
- bancos de dados;
- servidores DirectAdmin;
- servidores de gerenciamento;
- aplicações monolíticas.
8. Quando aumentar a RAM?
Considere aumentar memória quando houver evidências de pressão de RAM.
Indicadores:
Memória constantemente alta
Swap aumentando
OOM Killer
PHP-FPM limitado por memória
Banco reduzindo cache
Processos sendo encerrados
Verifique mensagens do kernel:
dmesg | grep -i oomEm alguns sistemas:
journalctl -k | grep -i oomSe houver eventos de OOM, é importante descobrir qual processo está provocando a pressão.
Aumentar RAM pode resolver o problema, mas também é importante corrigir a configuração que provocou o consumo excessivo.
9. Quando aumentar CPU?
Aumentar CPU faz sentido quando existe utilização elevada de processamento.
Verifique:
mpstat -P ALL 1 5Também:
topSe várias CPUs permanecem próximas de 100% durante períodos de carga, pode existir necessidade de mais processamento.
Porém, analise também:
CPU user
CPU system
I/O wait
steal time
processos
Se a CPU estiver baixa e o I/O wait estiver elevado, adicionar vCPUs pode não produzir o resultado esperado.
10. Avalie o armazenamento
Armazenamento é outro componente crítico.
Execute:
iostat -xz 1 10Observe principalmente:
await;%util;- operações de leitura;
- operações de escrita;
- throughput;
- latência.
Uma aplicação com muitas operações de banco de dados pode apresentar grande diferença ao migrar de SSD SATA para NVMe.
Arquitetura:
HDD
  ↓
SSD SATA
  ↓
NVMe
O ganho depende da aplicação e do padrão de I/O.
11. Monitore espaço em disco
Um servidor sem espaço pode apresentar diversos problemas.
Verifique:
df -hTambém:
df -iNão monitore somente o percentual de espaço utilizado.
Um filesystem pode ter espaço disponível, mas ficar sem inodes.
Para descobrir diretórios grandes:
du -xh --max-depth=1 / | sort -hPara /var:
du -xh --max-depth=1 /var | sort -hLogs, backups, cache e arquivos temporários são causas comuns de crescimento inesperado.
12. Otimize antes de adicionar servidores
Uma das principais regras de como escalar servidor é otimizar antes de escalar horizontalmente.
Analise:
- consultas SQL;
- PHP;
- cache;
- arquivos estáticos;
- imagens;
- API;
- processos em segundo plano;
- cron;
- banco;
- rede;
- armazenamento.
Uma aplicação mal otimizada pode continuar lenta mesmo depois de receber vários servidores.
13. Utilize cache
Cache reduz o trabalho necessário para gerar cada resposta.
Uma arquitetura simples:
Cliente
   ↓
Nginx
   ↓
Cache
   ↓
PHP-FPM
   ↓
MariaDB
Em WordPress, por exemplo, cache de página pode reduzir significativamente a quantidade de execuções PHP necessárias.
Existem diferentes níveis de cache:
Browser Cache
      ↓
CDN
      ↓
Page Cache
      ↓
Object Cache
      ↓
Application
      ↓
Database
Quanto mais requisições puderem ser atendidas sem executar todo o processamento, menor será a carga.
14. Utilize Redis
Redis pode ser utilizado como camada de cache e armazenamento em memória.
Arquitetura:
PHP
 │
 ├── Redis
 │
 └── MariaDB
Redis pode armazenar:
- sessões;
- object cache;
- resultados temporários;
- filas;
- dados frequentemente acessados.
Isso pode reduzir a quantidade de consultas repetitivas ao banco.
Entretanto, Redis não elimina a necessidade de otimizar MariaDB.
15. Otimize MariaDB
O banco de dados frequentemente se torna um gargalo quando o tráfego cresce.
Verifique conexões:
SHOW VARIABLES LIKE 'max_connections';E:
SHOW GLOBAL STATUS LIKE 'Threads_connected';Também:
SHOW FULL PROCESSLIST;Procure:
- consultas lentas;
- muitas conexões;
- tabelas sem índices adequados;
- bloqueios;
- operações repetitivas;
- consultas que permanecem abertas por muito tempo.
O slow query log pode ser extremamente útil para encontrar consultas problemáticas.
16. Escale o banco separadamente
Quando a aplicação cresce, pode chegar o momento em que Web e banco não deveriam mais compartilhar a mesma máquina.
Arquitetura inicial:
             SERVIDOR
        ┌─────────────────┐
        │ Nginx           │
        │ PHP-FPM         │
        │ MariaDB         │
        │ Redis           │
        └─────────────────┘
Arquitetura evoluída:
       WEB SERVER
    ┌──────────────┐
    │ Nginx        │
    │ PHP-FPM      │
    └──────┬───────┘
           │
           ↓
      DB SERVER
    ┌──────────────┐
    │ MariaDB      │
    │ NVMe         │
    │ RAM dedicada │
    └──────────────┘
Essa separação permite dimensionar os componentes individualmente.
17. Escale horizontalmente
Quando uma única máquina não é mais suficiente, adicione servidores.
Por exemplo:
Internet
   ↓
Load Balancer
   ↓
┌─────────┬─────────┬─────────┐
↓         ↓         ↓
Web 01   Web 02   Web 03
Cada servidor recebe parte das requisições.
Essa arquitetura permite aumentar a capacidade adicionando novos nós.
Por exemplo:
2 servidores
↓
3 servidores
↓
5 servidores
↓
10 servidores
dependendo da aplicação e da infraestrutura.
18. Utilize Load Balancer
O Load Balancer distribui requisições entre os servidores disponíveis.
Exemplo:
                 INTERNET
                    │
                    ↓
             Load Balancer
                    │
       ┌────────────┼────────────┐
       ↓            ↓            ↓
    Web 01        Web 02       Web 03
O balanceador pode utilizar diferentes estratégias, como distribuição por conexão ou mecanismos baseados em peso.
Também é importante configurar health checks.
Se o Web 02 estiver indisponível:
Web 01 ─── OK
Web 02 ─── OFFLINE
Web 03 ─── OK
o Load Balancer deve evitar encaminhar novas requisições para o servidor indisponível.
19. Torne a aplicação compatível com múltiplos servidores
Escalar horizontalmente exige atenção à aplicação.
Imagine:
Web 01armazenando uma sessão localmente.
O próximo acesso pode chegar ao:
Web 02Se a sessão estiver apenas no Web 01, podem surgir problemas.
Uma solução é armazenar sessões em um serviço compartilhado, como Redis.
O mesmo conceito pode ser aplicado a uploads.
Em vez de:
Web 01
└── /uploads
uma arquitetura distribuída pode utilizar armazenamento compartilhado ou object storage.
20. Separe arquivos e armazenamento
Quando existem múltiplos servidores web, arquivos locais podem virar um problema.
Por exemplo:
Web 01
└── imagem.jpg
O usuário pode acessar posteriormente:
Web 02e o arquivo não existir nesse servidor.
Uma solução é utilizar:
Object Storageou outro mecanismo de armazenamento compartilhado.
Arquitetura:
Web 01 ─┐
Web 02 ─┼──► Storage
Web 03 ─┘
Isso facilita o crescimento horizontal.
21. Utilize CDN quando apropriado
Uma CDN pode retirar parte do tráfego dos servidores de origem.
Arquitetura:
Usuário
   ↓
CDN
   ↓
Servidor de origem
Arquivos estáticos podem ser distribuídos pela rede da CDN:
CSS
JS
Imagens
Fontes
Vídeos
Arquivos estáticos
Isso reduz a quantidade de requisições que chegam diretamente ao servidor.
22. Escale tarefas em background
Nem todo processamento precisa acontecer durante a requisição HTTP.
Exemplo ruim:
Usuário
   ↓
PHP
   ↓
Processamento pesado
   ↓
Resposta
Uma alternativa:
Usuário
   ↓
PHP
   ↓
Fila
   ↓
Resposta rápida

Worker
   ↓
Processamento pesado
Filas permitem separar tarefas demoradas do processamento web.
Exemplos:
- envio de e-mails;
- processamento de imagens;
- geração de relatórios;
- importação de dados;
- sincronização;
- tarefas periódicas.
23. Use monitoramento para decidir quando escalar
A infraestrutura deve possuir métricas históricas.
Ferramentas como Zabbix, Prometheus, Grafana e Checkmk podem ajudar.
Monitore:
CPU
RAM
Swap
Load Average
Disk I/O
Disk latency
Network
PHP-FPM
MariaDB
Redis
HTTP 5xx
Response time
Connections
Por exemplo, uma regra de alerta pode indicar:
CPU > 85% durante 10 minutosou:
RAM disponível < 15%ou:
HTTP 5xx acima do limiteO histórico permite descobrir tendências antes que o problema se transforme em indisponibilidade.
24. Faça testes de carga
Antes de aumentar a infraestrutura, teste o comportamento da aplicação.
Ferramentas como wrk podem gerar requisições.
Exemplo:
wrk -t4 -c100 -d60s https://exemplo.com/Onde:
-t4utiliza quatro threads.
-c100mantém 100 conexões.
-d60sexecuta o teste por 60 segundos.
Durante o teste, acompanhe:
topvmstat 1iostat -xz 1O objetivo é descobrir onde o servidor começa a perder desempenho.
25. Analise p95 e p99
A média da latência pode esconder problemas.
Imagine:
95% das requisições: 200 ms
5% das requisições: 5 segundos
A média pode parecer aceitável, mas uma parcela dos usuários enfrenta uma experiência ruim.
Por isso, métricas como:
p50
p95
p99
são importantes em aplicações de maior tráfego.
O p95 mostra aproximadamente o tempo abaixo do qual estão 95% das requisições.
O p99 mostra o comportamento dos 99% das requisições.
26. Planeje capacidade
Não espere o servidor chegar a 100% para começar a pensar em expansão.
Crie uma margem operacional.
Por exemplo:
Capacidade atual
       ↓
Monitoramento
       ↓
Crescimento de tráfego
       ↓
Alerta
       ↓
Expansão
Se o tráfego cresce 20% ao mês, a infraestrutura precisa ser acompanhada continuamente.
O planejamento pode considerar:
- crescimento de usuários;
- crescimento de banco;
- crescimento de armazenamento;
- crescimento de requisições;
- crescimento de CPU;
- crescimento de RAM;
- crescimento de largura de banda.
27. Escalabilidade em VPS
Em uma VPS, a evolução pode começar de forma simples:
VPS
4 vCPU
8 GB RAM
Depois:
VPS
8 vCPU
16 GB RAM
Depois:
VPS
16 vCPU
32 GB RAM
Se o provedor oferecer recursos adicionais, também pode ser possível aumentar:
- armazenamento;
- largura de banda;
- IOPS;
- rede.
Quando os limites da VPS forem atingidos, considere migrar para servidor dedicado ou arquitetura distribuída.
28. Escalabilidade em servidor dedicado
No dedicado, existe maior controle sobre hardware.
Uma máquina pode possuir:
CPU
RAM ECC
NVMe
rede de alta capacidade
Isso pode ser interessante para:
- bancos de dados;
- aplicações de alto processamento;
- virtualização;
- hospedagem;
- grandes sites;
- sistemas que exigem recursos previsíveis.
Mesmo em um dedicado potente, o monitoramento continua sendo essencial.
Mais hardware não elimina gargalos de software.
29. Escalabilidade em cloud
Ambientes cloud facilitam algumas estratégias de expansão.
É possível combinar:
Compute
+
Load Balancer
+
Database
+
Object Storage
+
Cache
+
CDN
+
Monitoring
Uma aplicação pode começar com:
1 servidore posteriormente evoluir para:
Load Balancer
       │
 ┌─────┼─────┐
 ↓     ↓     ↓
VM1   VM2   VM3
       │
       ↓
    Database
A vantagem é poder separar componentes e ajustar capacidade conforme a necessidade.
30. Escalabilidade automática
Em ambientes preparados para isso, é possível utilizar Auto Scaling.
Exemplo:
Tráfego baixo
      ↓
2 servidores
Aumento de tráfego:
Tráfego alto
      ↓
4 servidores
Depois:
Tráfego reduzido
      ↓
2 servidores
O objetivo é adequar a capacidade à demanda.
Entretanto, Auto Scaling funciona melhor quando a aplicação já foi preparada para múltiplas instâncias.
31. Alta disponibilidade não é apenas escalabilidade
Escalar e aumentar disponibilidade são conceitos relacionados, mas diferentes.
Uma arquitetura com três servidores pode ter maior capacidade:
Web 01
Web 02
Web 03
Mas ainda pode existir um ponto único de falha.
Por exemplo:
Web 01 ─┐
Web 02 ─┼──► único banco
Web 03 ─┘
Se o banco parar, toda a aplicação pode ficar indisponível.
Por isso, arquiteturas críticas precisam analisar:
- redundância;
- backup;
- replicação;
- failover;
- Load Balancer;
- monitoramento;
- recuperação de desastre.
32. Crie uma estratégia de backup
Escalabilidade sem proteção de dados é um risco operacional.
Tenha backups para:
Banco de dados
Arquivos
Configurações
Certificados
DNS
Infraestrutura
Sempre que possível, mantenha cópias fora do servidor principal.
Uma arquitetura simples:
Servidor
   ↓
Backup local
   ↓
Backup externo
Também teste regularmente a restauração.
Um backup que nunca foi restaurado pode não estar pronto para uma situação real de desastre.
33. Evite os erros mais comuns
Ao estudar como escalar servidor, alguns erros aparecem repetidamente.
Erro 1: aumentar CPU sem investigar
Se o gargalo está no disco, mais CPU não resolverá.
Erro 2: aumentar RAM sem controlar processos
PHP-FPM, banco e outros serviços podem continuar consumindo memória excessivamente.
Erro 3: aumentar max_connections indiscriminadamente
Mais conexões não significam automaticamente mais desempenho.
Erro 4: adicionar servidores sem preparar a aplicação
Sessões e arquivos locais podem causar inconsistências.
Erro 5: ignorar banco de dados
Muitas aplicações escalam o frontend enquanto o banco continua sendo o gargalo.
Erro 6: não monitorar
Sem métricas, você não sabe se a mudança realmente resolveu o problema.
Erro 7: não realizar testes
Uma alteração aparentemente boa pode produzir efeitos inesperados sob carga.
34. Exemplo prático de evolução
Considere um site inicialmente hospedado em:
4 vCPU
8 GB RAM
SSD
A primeira etapa é monitorar.
Depois foi identificado:
CPU: 90%
RAM: 60%
I/O wait: baixo
Nesse caso, pode fazer sentido aumentar CPU.
A infraestrutura passa para:
8 vCPU
8 GB RAM
Depois de alguns meses:
CPU: 80%
RAM: 90%
Aumenta-se RAM:
8 vCPU
16 GB RAM
Posteriormente, o banco passa a apresentar latência elevada.
Então pode ser necessário:
NVMeDepois:
Web Server
+
Database Server
Finalmente, com crescimento significativo:
CDN
   ↓
Load Balancer
   ↓
Web 01
Web 02
Web 03
   ↓
Redis
   ↓
Database
   ↓
Backup
Essa evolução é muito mais eficiente do que simplesmente aumentar o servidor sem diagnóstico.
35. Checklist para escalar um servidor
Antes de fazer qualquer alteração, verifique:
[ ] CPU
[ ] RAM
[ ] Swap
[ ] Load Average
[ ] I/O wait
[ ] Latência do disco
[ ] Espaço em disco
[ ] Inodes
[ ] Rede
[ ] PHP-FPM
[ ] Nginx/Apache
[ ] MariaDB/MySQL
[ ] Redis
[ ] Processos
[ ] Logs
[ ] Erros HTTP
[ ] Tempo de resposta
[ ] Backup
[ ] Monitoramento
Depois determine:
Gargalo identificado?
        │
       SIM
        ↓
Existe otimização possível?
        │
   ┌────┴────┐
  SIM       NÃO
   ↓          ↓
Otimizar    Escalar
             │
       ┌─────┴─────┐
       ↓           ↓
    Vertical   Horizontal
36. Estratégia recomendada de escalabilidade
Uma sequência prática pode ser:
Fase 1 — Diagnóstico
Monitorar
↓
Identificar gargalo
↓
Medir desempenho
Fase 2 — Otimização
PHP-FPM
MariaDB
Nginx
Cache
Redis
Aplicação
Fase 3 — Scale-up
Mais CPU
Mais RAM
NVMe
Fase 4 — Separação
Web
↓
Database
Fase 5 — Scale-out
Load Balancer
↓
Web 01
Web 02
Web 03
Fase 6 — Arquitetura distribuída
CDN
Load Balancer
Web Servers
Redis
Database
Storage
Workers
Monitoring
Backup
Essa abordagem reduz mudanças desnecessárias e permite que a infraestrutura cresça conforme a necessidade real.
Conclusão
Aprender como escalar servidor não significa simplesmente contratar uma máquina com mais CPU e memória. Escalabilidade eficiente começa com diagnóstico, monitoramento e identificação precisa dos gargalos.
Em uma primeira etapa, pode ser suficiente aumentar CPU, RAM ou migrar para NVMe. Conforme o sistema cresce, cache, Redis, otimização de PHP-FPM e banco de dados podem proporcionar ganhos importantes.
Quando uma única máquina deixa de ser suficiente, a arquitetura pode evoluir para múltiplos servidores, Load Balancer, banco de dados dedicado, armazenamento compartilhado, CDN e processamento assíncrono.
A sequência mais segura é:
MEDIR
  ↓
IDENTIFICAR
  ↓
OTIMIZAR
  ↓
TESTAR
  ↓
SCALE-UP
  ↓
SEPARAR SERVIÇOS
  ↓
SCALE-OUT
  ↓
AUTOMATIZAR
Para VPS, servidor dedicado ou cloud, o princípio permanece o mesmo: não escale o que não é o gargalo.
Uma infraestrutura bem escalada deve oferecer capacidade suficiente, margem operacional, monitoramento, backup e possibilidade de expansão sem precisar reconstruir toda a arquitetura a cada aumento de tráfego.
FAQ — Como Escalar Servidor
Escalar um servidor significa aumentar sua capacidade para suportar maior quantidade de usuários, requisições, processos, dados ou operações. Isso pode ser feito aumentando recursos da máquina ou adicionando novos servidores.
Scale-up aumenta os recursos de uma máquina existente, como CPU, RAM e armazenamento. Scale-out adiciona novas máquinas para distribuir a carga.
A RAM deve ser aumentada quando existe pressão de memória, uso frequente de swap, processos sendo encerrados por falta de memória ou consumo persistentemente próximo da capacidade disponível.
Aumentar CPU é indicado quando o processamento é o principal gargalo e os processadores permanecem altamente utilizados durante períodos de carga.
A migração pode ser considerada quando a VPS não oferece recursos, previsibilidade ou capacidade de expansão suficientes para a carga da aplicação.
Sim. Redis pode reduzir consultas repetitivas ao banco e armazenar cache, sessões e outros dados temporários, diminuindo a carga de componentes da aplicação.
Um Load Balancer pode distribuir requisições entre múltiplos servidores e permitir expansão horizontal da camada web.
Sim. WordPress pode ser escalado utilizando cache, CDN, Redis, otimização do banco, PHP-FPM dimensionado corretamente, servidores web adicionais e outras técnicas.
Analise consultas lentas, conexões, locks, latência, uso de CPU, memória e I/O. O monitoramento do banco deve ser feito em conjunto com as métricas do sistema operacional.
Depende do gargalo, da aplicação e dos requisitos de disponibilidade. A escalabilidade vertical normalmente é mais simples, enquanto a horizontal permite distribuir a carga e aumentar a capacidade adicionando novas máquinas.
Veja Também:
Como Otimizar VPS, Servidor Dedicado ou Cloud: Guia Completo
Servidor Lento: Identifique Gargalo em VPS, Dedicado ou Cloud
CPU 100%: Diferenças Entre VM e Bare Metal no Servidor
iowait Alto NVMe Cloud: Como Diagnosticar Gargalo de Disco
Steal Time Alto na VPS: O Que É e Como Resolver o Gargalo
Como Medir Performance de Servidor Linux na Prática (Além da CPU)